原生同步,无需后期剪辑
Kling 3.0 Omni 在单次生成中按台词生成声音并对上嘴部动作,无需手动打关键帧或后期处理。
上传人脸、写下台词,Kling 3.0 Omni 自动配音并对上口型;用自己的歌或录音也行。
在 Renoise Canvas 中上传参考人脸照片,在提示词里写下台词并描述表演场景,选择 Kling 3.0 Omni 渲染——它会按台词自己生成声音,并一步对齐嘴部动作。想让人像跟着你自己的歌或录音开口,就把人像和录音交给 Renoise Agent,由 OmniHuman 2.0 让口型跟着录音走。若使用真人肖像,只限你拥有肖像授权的面孔——你本人,或已取得书面同意的人;名人和公众人物不可使用。
只想让静态照片开口说台词而非演唱?请参阅 AI 说话照片指南
Kling 3.0 Omni 原生口型同步——开始前先了解这些要点。
Kling 3.0 Omni 在单次生成中按台词生成声音并对上嘴部动作,无需手动打关键帧或后期处理。
单次口型同步生成支持 3–15 秒的片段。生成的视频片段可直接在 Renoise 中编辑和裁剪。
把人像和一段人声录音(说话或演唱均可,4–300 秒)交给 Renoise Agent,OmniHuman 2.0 让口型跟着录音走;没有人声的纯音乐不行。
只能同步你拥有肖像授权的真人肖像——你本人,或已取得书面同意的人;名人和公众人物不可使用。
从参考人脸和台词到同步表演视频,全程在 Renoise Canvas 内完成。以下示例均使用原创虚构角色演示。
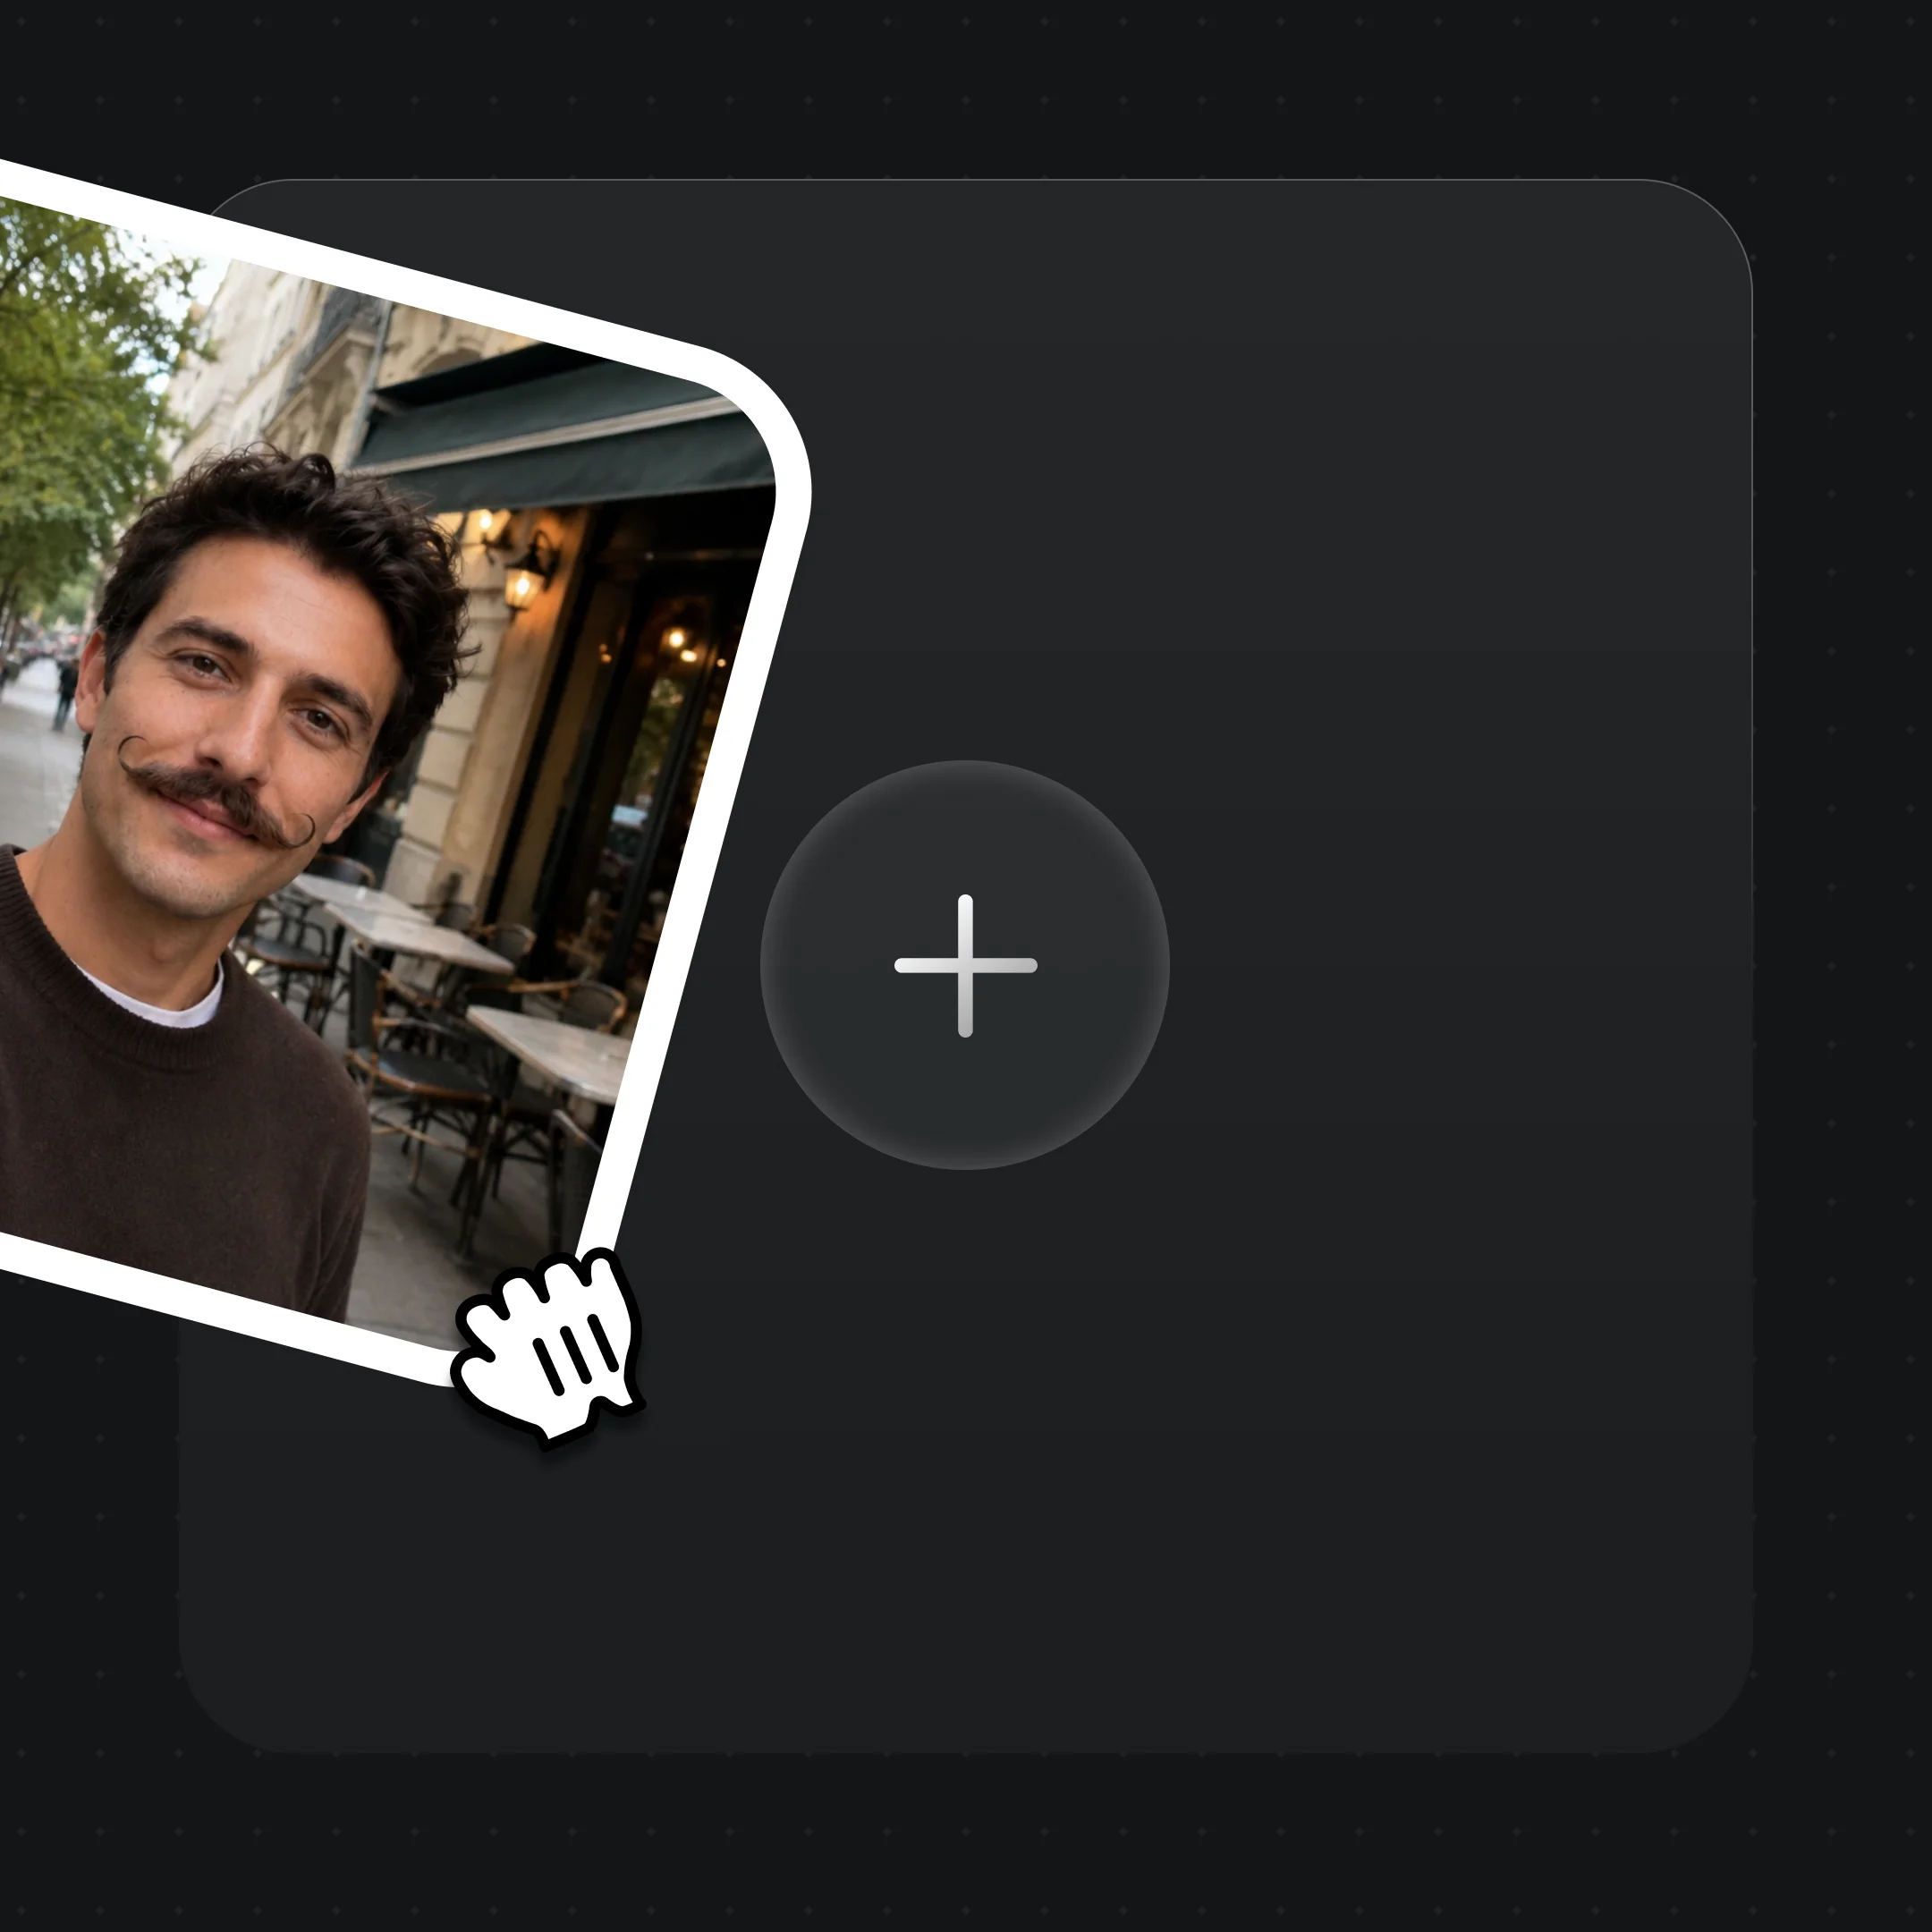
将清晰的正面参考照片拖入 Canvas。若为真实人物,必须是你拥有肖像授权的面孔。
写出角色要说的台词,再描述场景、情绪与风格,例如"霓虹舞台上的主持人热情地说:欢迎来到今晚的演出!宽景镜头"。
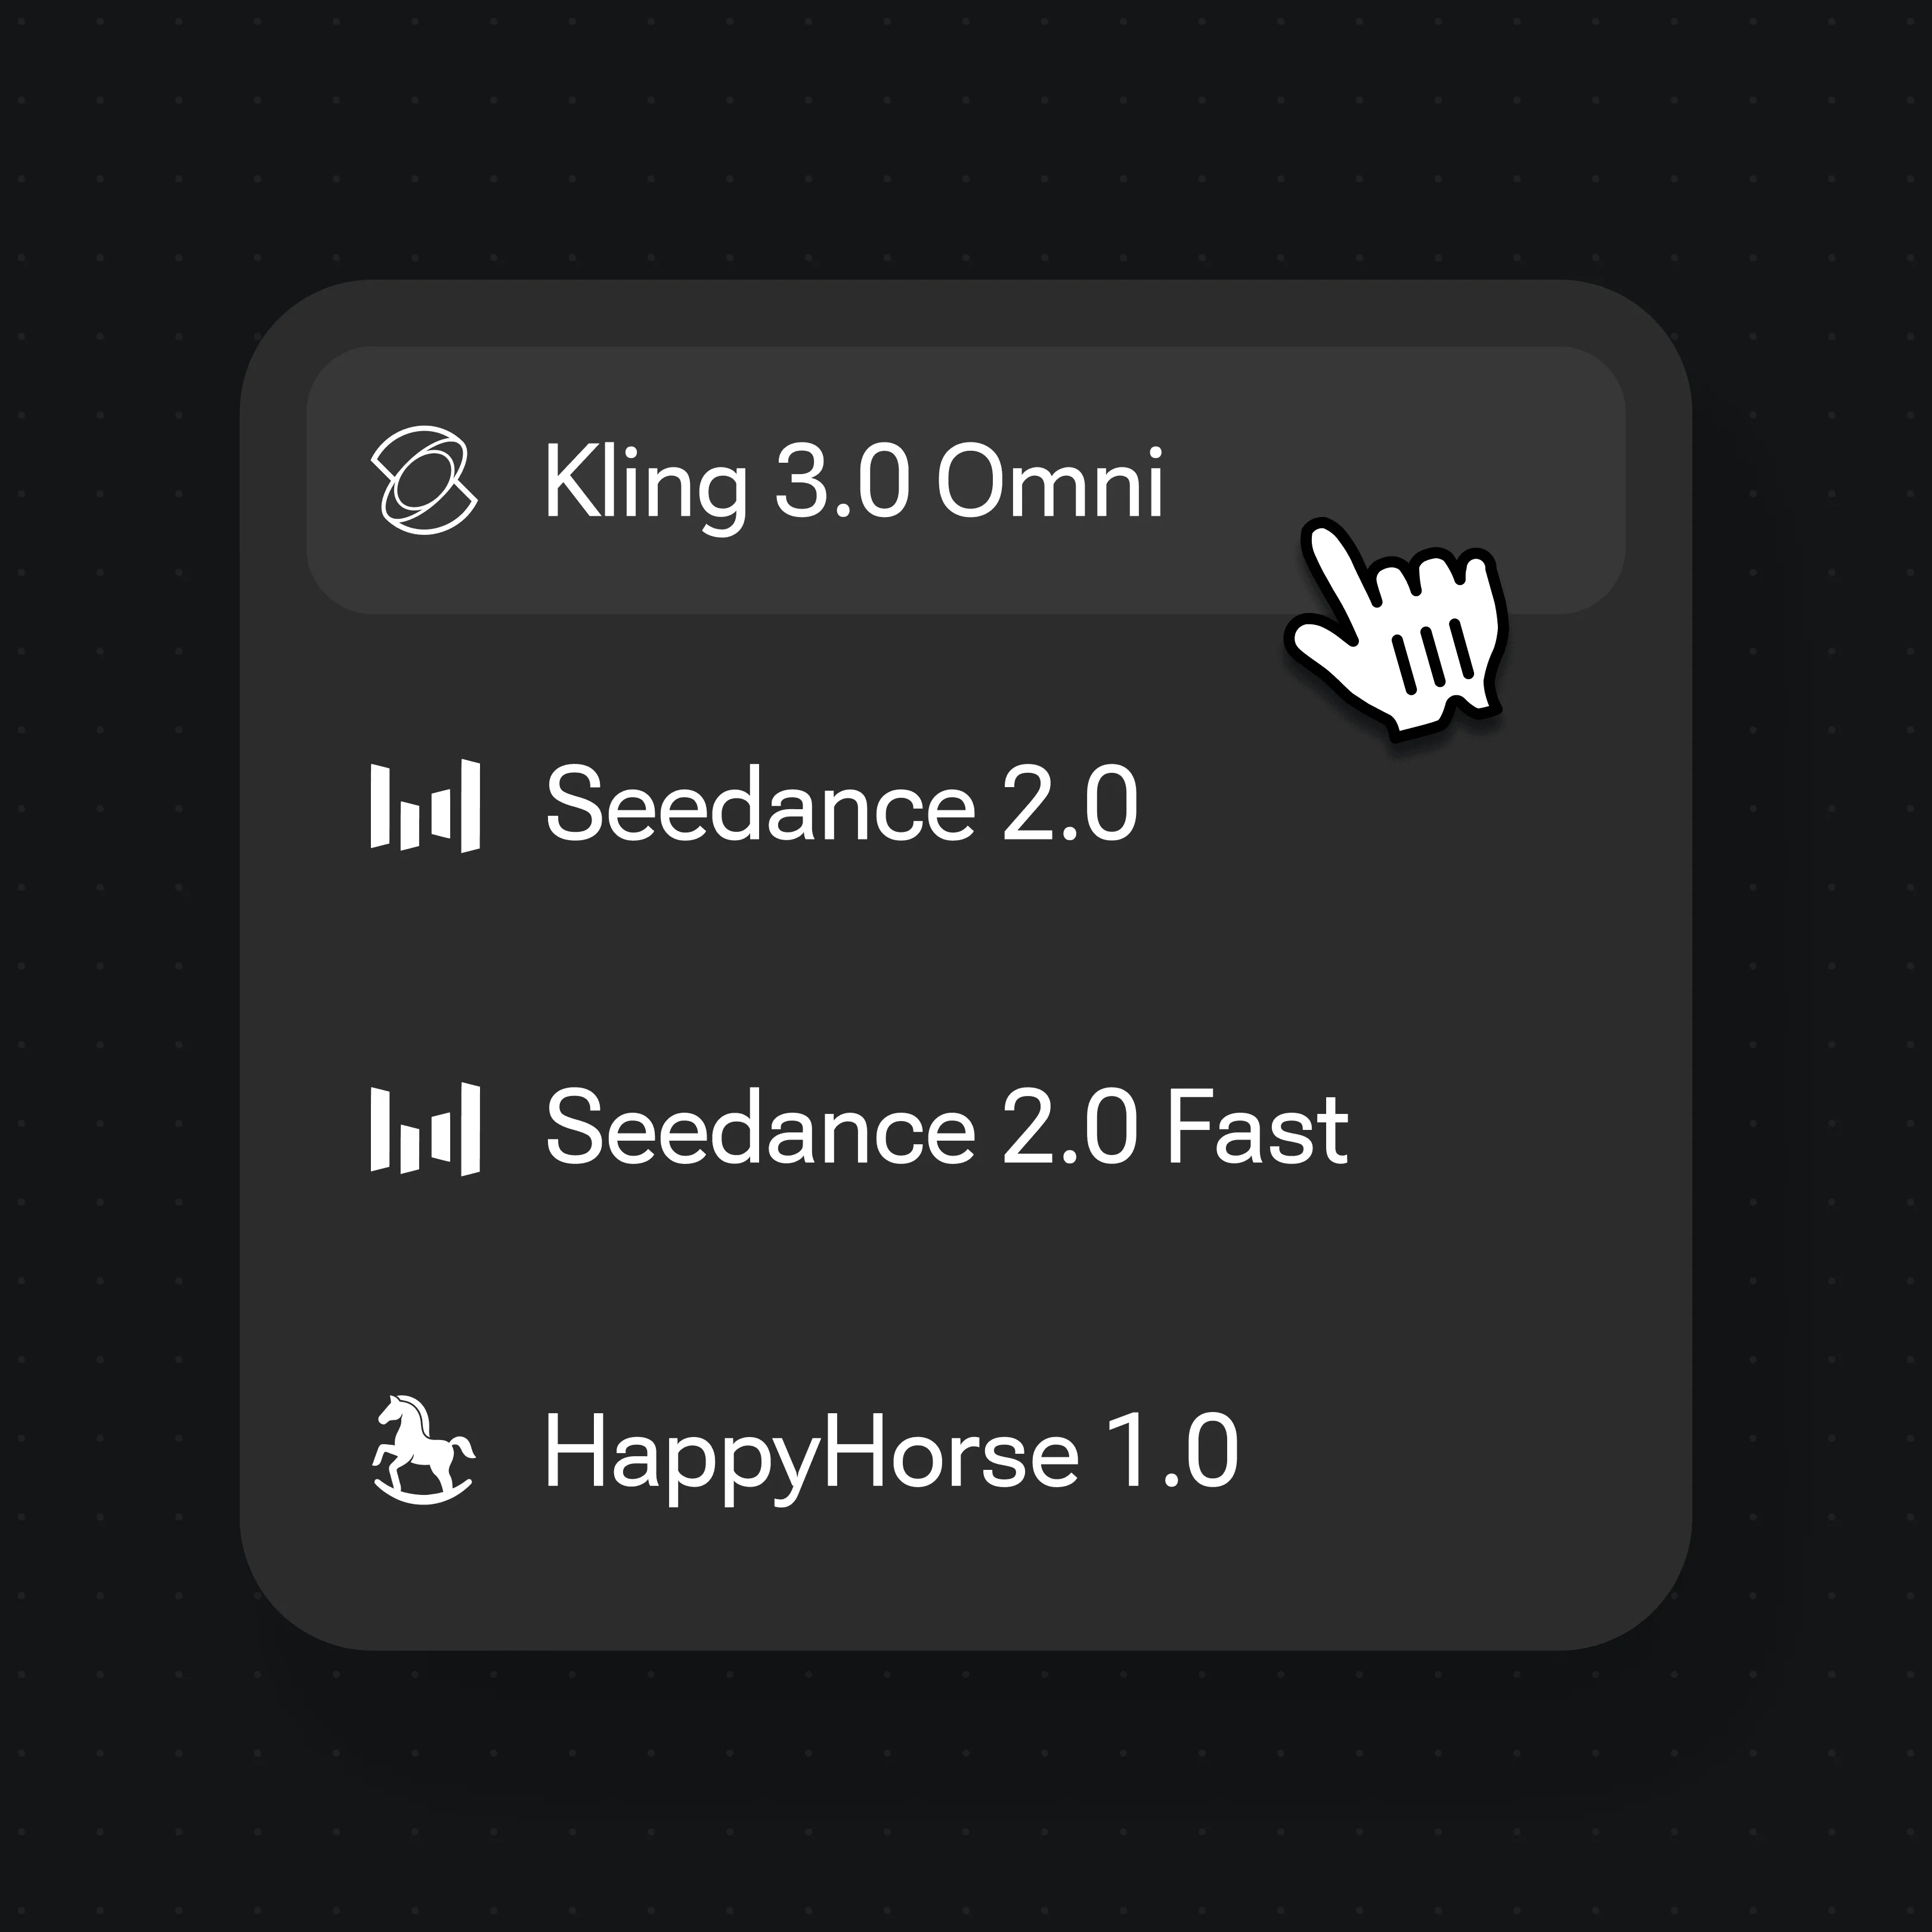
在模型菜单中选择 Kling 3.0 Omni——它原生支持口型同步,声音和嘴型一起生成。完成后导出同步视频片段。
以下示例均由 Renoise 原创虚构角色生成——同样的流程适用于任何已授权的人脸。
原创 3D 风格歌手角色在霓虹舞台上随音乐同步表演
原创虚构主持人身着米色西装,在演播室场景中同步播报
原创虚构厨师角色在厨房中同步口播旁白
原创暗黑奇幻风战士角色在火光氛围中同步演讲
口型同步的核心是将音频映射至嘴型。语音或歌唱中的每一个独立发音——即音素——都对应一个可见的嘴部形态,称为"视素"(viseme)。由快手研发的 Kling 3.0 Omni 会按你写在提示词里的台词生成语音,再逐帧驱动下颌、嘴唇和面颊匹配对应的音素形态。最终结果是一段由参考人脸和台词一次性生成的同步说话视频——无需手动动画或后期处理。Kling 不接收上传的音频;要让人像跟着你自己的歌或录音开口,Renoise 用的是字节跳动的 OmniHuman 2.0:把一张人像和一段人声录音交给 Renoise Agent,口型跟着录音走,视频时长等于录音时长,输出 720p。
参考人脸决定人物身份:模型在整个片段中保持人脸一致,仅让说话动画发生变化。这正是一张静态肖像能变成演唱歌手或播音主持的原因——面部特征保持可辨认,嘴部和表情随之运动。
对于虚构角色、插画形象或 AI 生成的人脸,整个流程无需额外步骤。真实、可辨认的人脸则只限你拥有肖像授权的——你本人,或已取得书面同意的人;即便如此,面孔仍可能被拒绝。
这意味着,你无法在 Renoise 中生成名人或公众人物的口型同步视频,未成年人同样不允许,并须遵守当地法律。但你可以使用自己的人脸、已取得书面同意的对象,或完全原创的虚构角色。本页所有演示示例均采用原创虚构角色,仅用于说明操作流程。
一个套餐即可解锁 Kling 3.0 Omni 和其它所有视频模型。
适合初次尝试 AI 创作
按月计费
≈ 150 次 GPT Image 2 生成
≈ 60 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合每周持续创作
按月计费
≈ 450 次 GPT Image 2 生成
≈ 180 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合专业规模产出
按月计费
≈ 1,750 次 GPT Image 2 生成
≈ 700 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合初次尝试 AI 创作
每月,按年计费
节省 $72(相比月付)
≈ 150 次 GPT Image 2 生成
≈ 60 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合每周持续创作
每月,按年计费
节省 $216(相比月付)
≈ 450 次 GPT Image 2 生成
≈ 180 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合专业规模产出
每月,按年计费
节省 $720(相比月付)
≈ 1,750 次 GPT Image 2 生成
≈ 700 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
不能。名人和公众人物不允许使用。真人脸只限你拥有肖像授权的面孔,你可以改用自己的人脸、已取得书面同意的对象,或完全原创的虚构角色。
Kling 3.0 Omni 不接收上传的音频——你在提示词里写下台词,它自己生成声音并对口型。要用自己的录音或歌曲,请把一张人像和一段 mp3 或 wav(4–300 秒,说话或演唱均可)交给 Renoise Agent,由 OmniHuman 2.0 让嘴型跟着录音走;只有伴奏、没有人声的纯音乐会被拒绝。
单次 Kling 3.0 Omni 生成支持 3–15 秒的片段;走 Renoise Agent 用自己的录音时,OmniHuman 2.0 的视频与录音等长(4–300 秒)。生成的视频片段可直接在 Renoise 中编辑和裁剪。
清晰的正面肖像效果最佳。人脸应光线充足、无遮挡,且大致面向镜头。侧角度、强阴影或局部遮挡会降低口型同步质量,因为模型用于锚定嘴部动画的面部几何信息不足。
用的是你有权使用的脸就可以。Renoise 的口型同步是一款需获授权的 AI 视频生成工具,不能用来冒充他人:真实人脸只限你本人,或已取得书面同意的人;名人、公众人物和未成年人不可使用,并须遵守当地法律。
可以。虚构或 AI 生成的人脸无需肖像授权。先生成一个原创角色,再将该角色作为口型同步的参考人脸使用。本页所有演示示例均采用这种方式——全部为原创虚构角色。
由快手研发的 Kling 3.0 Omni 是 Renoise 中提供原生口型同步的模型。"原生"意味着口型同步内置于生成流程中——你提供人脸和台词,声音和同步画面一次性输出,无需额外处理步骤。要对上你自己的录音,则由 OmniHuman 2.0 负责,它只能在 Renoise Agent 里使用。
底层流程完全相同——都是用 Kling 3.0 Omni 原生口型同步,输入参考人脸和台词;想用自己的录音,两者都交给 Renoise Agent 的 OmniHuman 2.0。区别在于使用意图:说话照片通常是主持人或演讲者口播脚本;明星口型同步则指表演或演唱的娱乐用途。演讲者场景请参阅 AI 说话照片指南。