演播室主播
明亮的演播室构图、眼神看向镜头——口播公告或产品演示的默认观感。
让一张静态照片化身唇形同步的口播数字人,念出任意台词。
把一张清晰的正面人像拖进 Renoise Canvas,输入要念的台词或附上音频,然后用 Kling 3.0 Omni 渲染。它的原生唇形同步会根据你的文字驱动嘴部和面部,把静态照片变成会说话的数字人。如果是真人,请先通过 FacePass 完成肖像授权。
本指南面向唇形同步的口播数字人。如果只想让照片产生没有对白的常规动态,请查看 AI 照片转视频工具页
在 Renoise 里用三步把一张人像变成唇形同步的口播数字人。
把一张清晰的正面人像拖进 Canvas。如果是真人,请先通过 FacePass 完成肖像授权。
在提示词里写下要念的台词,或附上一段音频——Kling 3.0 Omni 会把它当作唇形同步的来源。
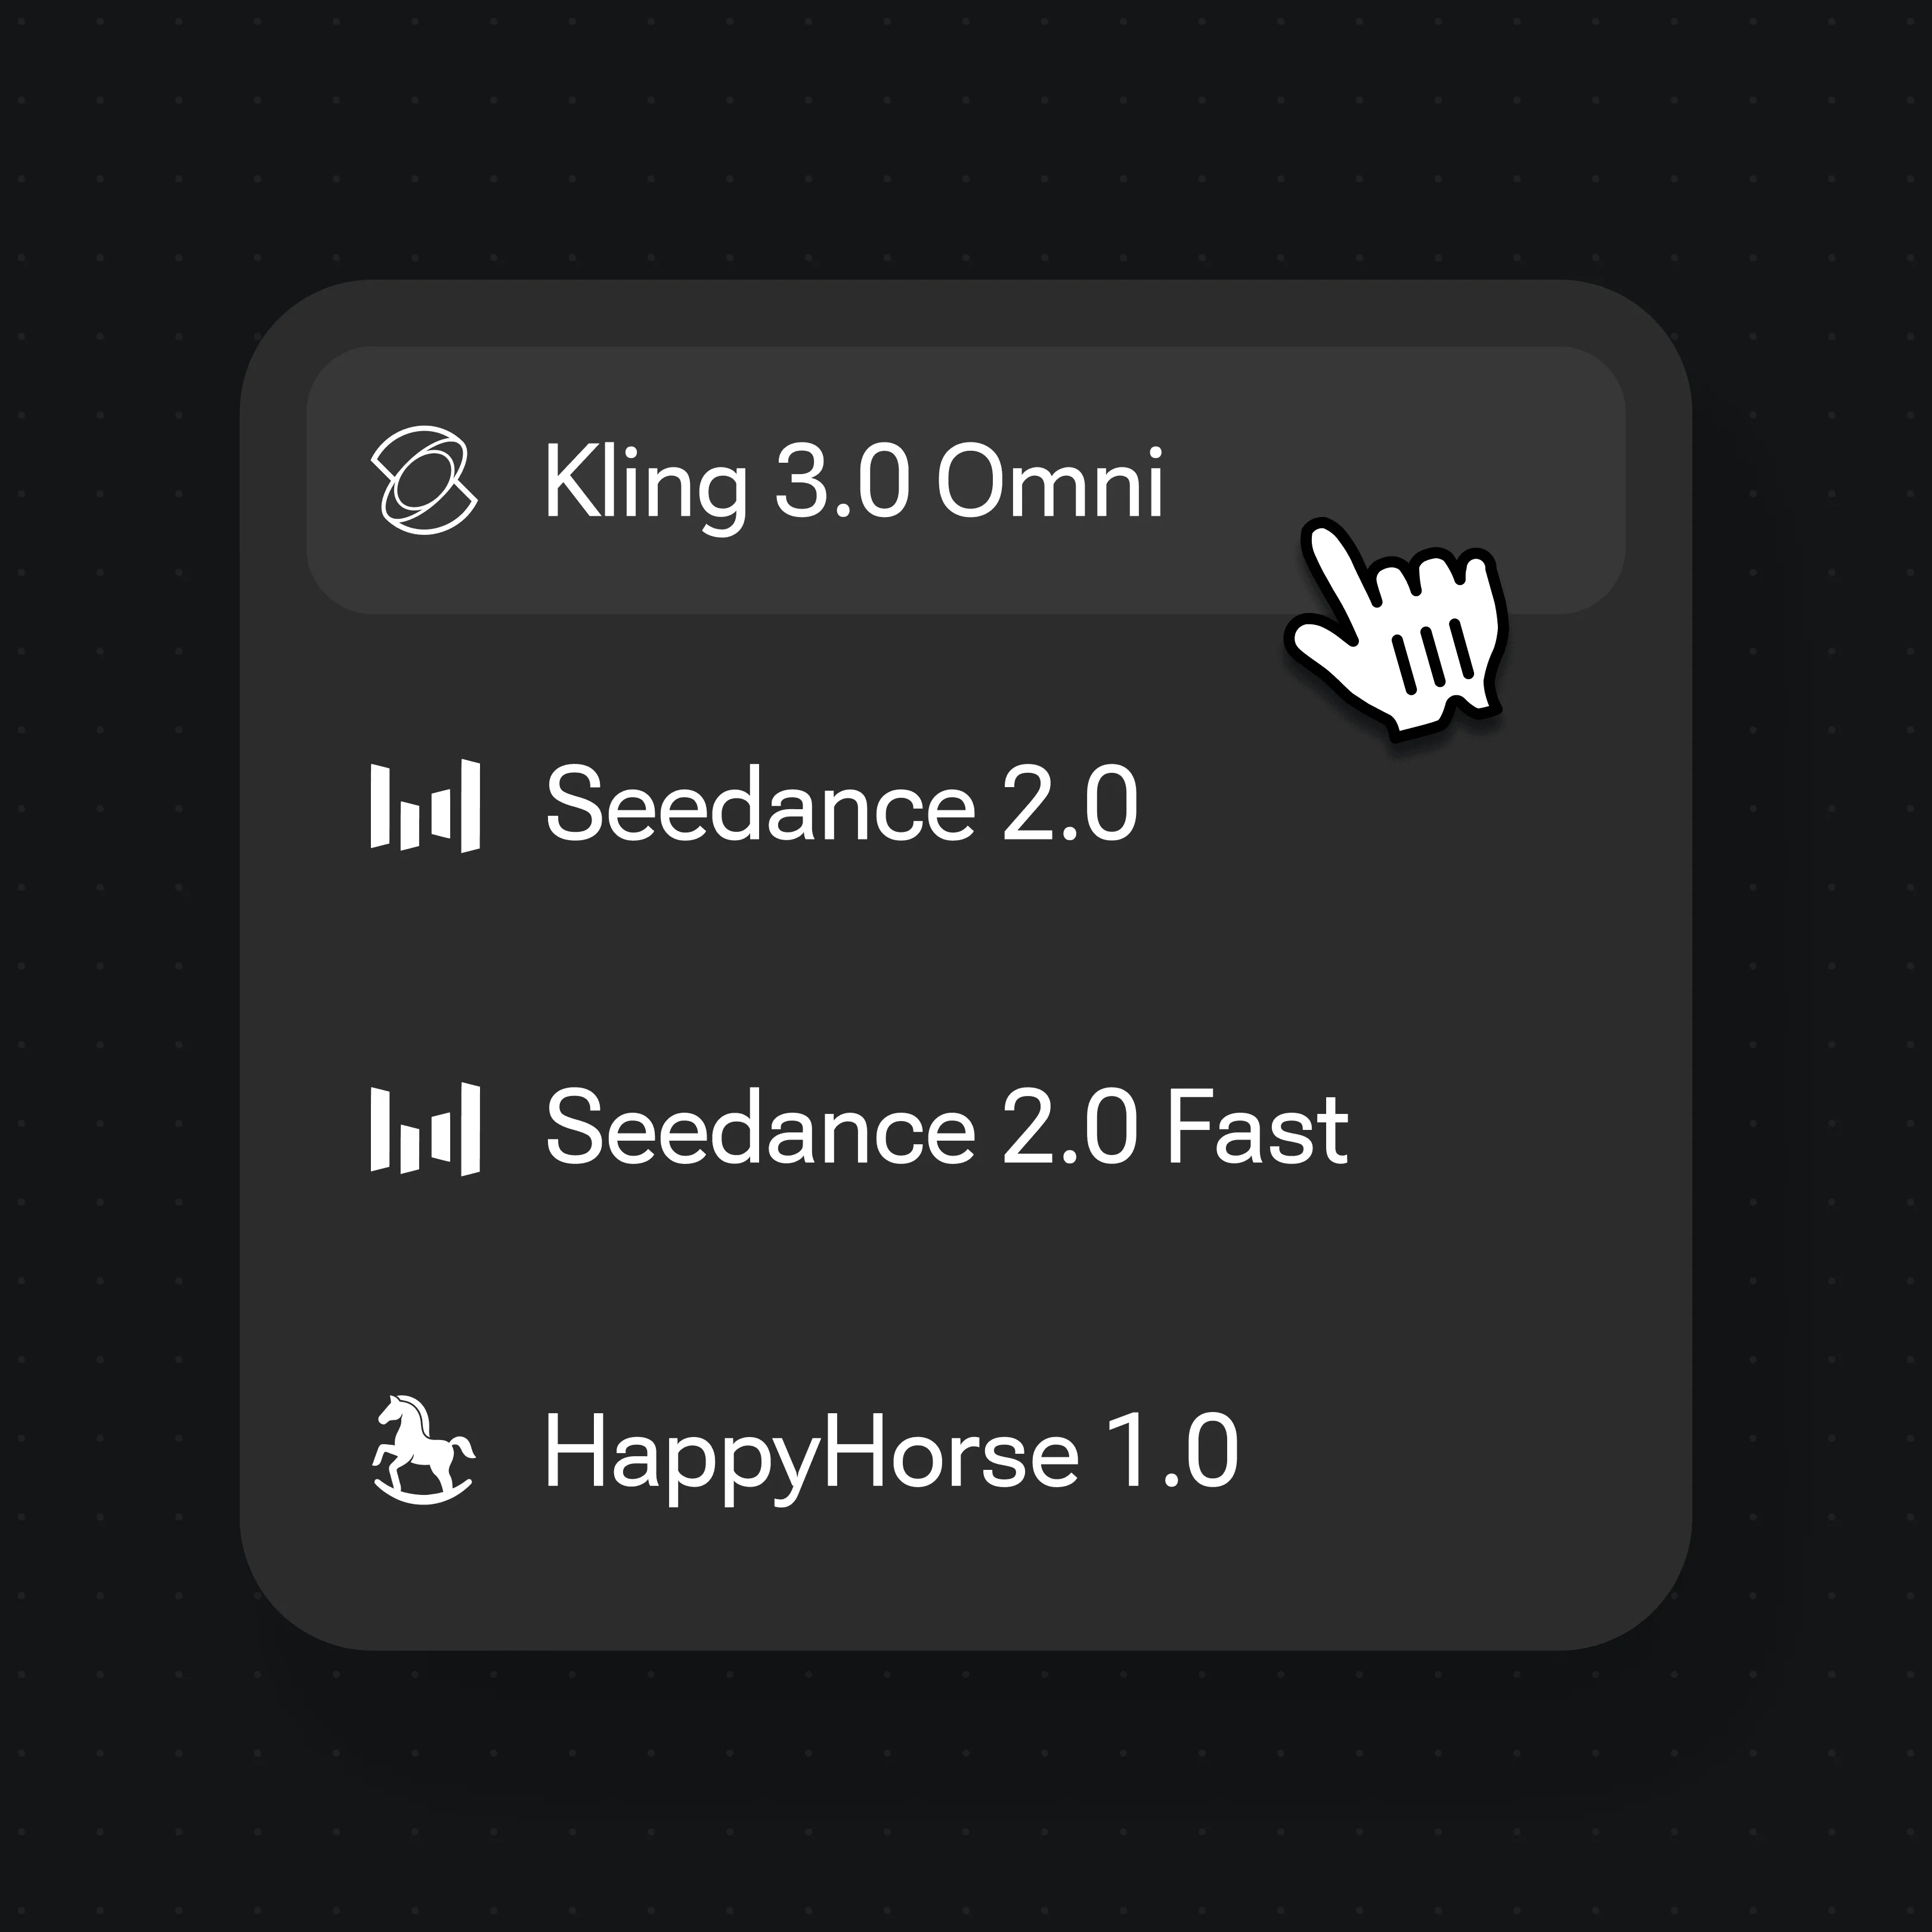
在模型菜单里选择 Kling 3.0 Omni 以启用原生唇形同步,然后渲染口播片段。
用 Renoise 制作的主播风格片段——正是会说话的照片切到的那种构图。
明亮的演播室构图、眼神看向镜头——口播公告或产品演示的默认观感。
一张安静的户外人像,主角直视前方——传递真诚口播信息的自然构图。
人物稳稳立于繁忙街道之前——出外景口播片段的记者式布置。
一张自信的户外人像衬以干净墙面——适合做主持人开场或发言人数字人。
会说话的照片和完整 AI 视频不是一回事。常规的文生视频片段会凭一段提示词凭空生成动作、运镜和整个场景。而会说话的照片从你提供的一张静态人像出发,只加上一样东西:由音频驱动的嘴部和面部。画面、身份和构图都锚定在你的照片上,只有说话这一部分在动。正因如此,它看起来还是同一个人,而不是一次全新生成。
唇形同步是把语音映射到口型的技术。每一个音素——单词中各不相同的发音——都对应一个视位,也就是观众预期看到的口型。模型逐帧把它们对齐,让嘴唇、下巴和脸颊跟随你提供的任意音频,无论是它替你念出的文字台词,还是你附上的录音。
在 Renoise 里,Kling 3.0 Omni 原生处理这一切——无需另外加挂一道唇形同步流程。你拖入人像,提供台词或语音轨,模型一步就渲染出口播片段。如果是真人,FacePass 会先完成肖像授权,并在整段片段里稳住那张脸,让数字人在说话时始终可辨认。
会说话的照片依赖几项能力——而 Renoise 在一块画布里同时给你 Kling 3.0 Omni 和其它众多视频模型。
为视频完成真人肖像授权,让他们的照片可以合法地变成会说话的数字人。
原生唇形同步根据你的台词或音频驱动嘴部和面部——无需另装唇形同步工具。
用输入的文字或附上的语音轨驱动数字人,支持多种口语语言。
逐段在 Kling 3.0 Omni 和其它视频模型之间切换——全在同一个项目里。
一个套餐即可解锁 Kling 3.0 Omni 和其它所有视频模型。
适合初次尝试 AI 创作的用户
每年收取 $168
升级计划每年节省 $72
适合每周持续产出内容的创作者
每年收取 $504
升级计划每年节省 $216
适合商业规模产出的工作室与专业团队
每年收取 $1680
升级计划每年节省 $720
适合初次尝试 AI 创作的用户
按月计费
升级计划适合每周持续产出内容的创作者
按月计费
升级计划适合商业规模产出的工作室与专业团队
按月计费
升级计划每年自动续费,直至取消。
每月自动续费,直至取消。
把一张清晰的正面人像拖进 Renoise Canvas,输入要念的台词或附上音频,然后用 Kling 3.0 Omni 渲染。它的原生唇形同步会根据你的文字驱动嘴部和面部,把静态照片变成会说话的数字人。
当你想让照片配着同步音频说话时,用这个流程。如果只想要常规动态——运镜、主角转身或走动、没有对白——那属于照片动画,请改用我们的 /features/photo-to-video-ai 照片转视频工具页。
可以,前提是你拥有该肖像的权利。视频模型默认会屏蔽真实人脸,所以请先通过 FacePass 完成肖像授权。FacePass 是在真人肖像变成会说话的数字人之前进行合规授权的途径。
不行。FacePass 只为你有权使用的肖像授权,不允许使用你并不代理的名人或公众人物。请改用你自己的照片、已征得同意的对象,或一张完全原创的 AI 生成人脸。
会。附上一段语音轨,Kling 3.0 Omni 就会把它当作唇形同步来源,让嘴部贴合你的录音。你也可以输入台词让模型念出来——两者驱动的是同一套原生唇形同步。
Kling 3.0 Omni 支持多种口语语言的唇形同步。用目标语言输入台词,或附上该语言的音频,嘴部动作就会跟随所给内容的音素。
Kling 3.0 Omni 每段片段上限为 15 秒。生成的视频片段可直接在 Renoise 中编辑和裁剪。